반응형

전체 글 44

[RDKit란?] 무엇을 하는지, 세팅방법

RDKit는 원래 “Rational Discovery Kit”의 약자로,Rational Discovery라는 이름의 생명정보 스타트업에서 내부적으로 개발한 툴입니다.2006년경 오픈소스로 공개되면서 회사 이름은 사라졌지만, “RDKit”이라는 이름만 남아 지금까지 유지된 거라고 해요.(출처 )https://rdkit.readthedocs.io/en/latest/Overview.html 그렇다면 RDKit는 내가 왜 공부하는가 !!내가 왜 알아야하는가 !! RDKit를 통해 모델이나 AI가 이해할 수 있는 형태로 분자를 데이터화 할 수 있기 때문입니다 ~~! 다시 정리하자면, RDKit는 분자 구조를 다루는 파이썬/ C++ 기반 케모인포매틱스(Cheminformatics) 라이브러리로,SMILES/..
크로스 어텐션(Cross-Attention)이란?

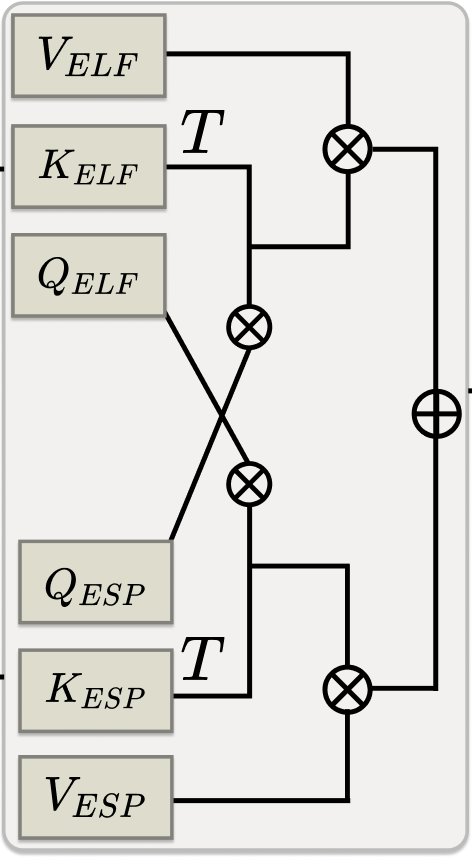
크로스 어텐션은 트랜스포머(Transformer) 모델의 핵심 메커니즘 중 하나로, 두 가지 서로 다른 정보(시퀀스 또는 임베딩) 간의 관계를 학습하고, 한 정보가 다른 정보에 대해 얼마나 "주의(attention)"를 기울여야 하는지를 결정하는 방식이다.셀프 어텐션(Self-Attention)이 하나의 시퀀스 내부 요소들 간의 관계를 학습하는 반면, 크로스 어텐션은 '쿼리(Query)'를 제공하는 하나의 입력(환자정보)이 '키(Key)'와 '값(Value)'을 제공하는 또 다른 입력(약물 정보)에 어떻게 주의를 기울여야 하는지를 계산한다. 작동 방식:쿼리(Query, Q): 하나의 정보원에서 나온다. "내가 무엇을 찾고 있는가?"에 해당다. (예: 환자 정보)키(Key, K): 다른 정보원에서 나온다...

어텐션 기반 융합 (Attention-based Fusion)

어텐션 기반 융합(Attention-based Fusion)과 트랜스포머 인코더(Transformer Encoder)는관련성이 깊지만, 동일한 개념은 아니다. 트랜스포머 인코더를 사용하여 임베딩을 병합하는 것은 어텐션 기반 융합의 한 종류이자, 기존의 단순한 융합 방식과는 확실히 다른 시도이자 더 발전된 실험이 될 수 있다. 1. 어텐션 기반 융합 (Attention-based Fusion) 어텐션 메커니즘은 입력 데이터의 여러 부분 중 어떤 부분이 현재 작업에 더 중요한지 모델이 '주목'하게 하는 메커니즘이다.어텐션 기반 융합은 이 어텐션 메커니즘을 사용하여 여러 모달리티의 정보를 결합하는 방식이다.작동 방식:각 모달리티의 임베딩이 주어진다.모델은 이 임베딩들 각각에 대해 중요도 점수(어텐션 가중치)..

비전 트렌스포머 (Vision Transformer, ViT)1

비전 트랜스포머(Vision Transformer, ViT)는 이미지 처리 분야에 트랜스포머(Transformer) 아키텍처를 적용한 딥러닝 모델이다. 일반적으로 이미지 처리에는 합성곱 신경망(Convolutional Neural Network, CNN)이 주로 사용되는데,ViT는 CNN 없이도 이미지 분류와 같은 작업에서 뛰어난 성능을 보여주면서 주목받기 시작했다. ViT는 이미지를 처리하는 방식이 기존 CNN과 다르다.어떤 부분이 다르냐 하면, 1) 이미지 패치화: 먼저 이미지를 여러 개의 작은 패치(patch)로 분할한다. 이 때 각 패치는 마치 텍스트의 단어처럼 취급된다. 2) 선형 임베딩: 분할된 각 이미지 패치를 선형 임베딩(linear embedding)을 통해 벡터로 변환한다. 이 과정에서..

ELF와 ESP 에너지맵 특징 분석해보기 (for Pooling)

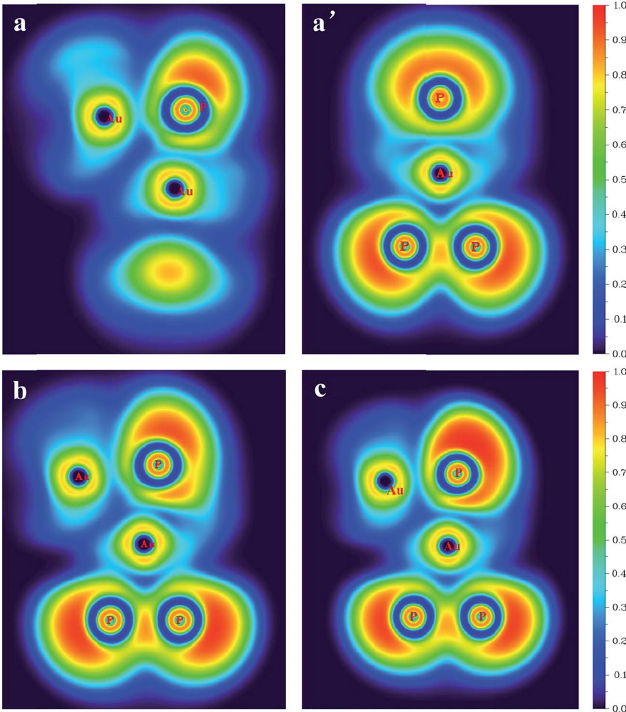
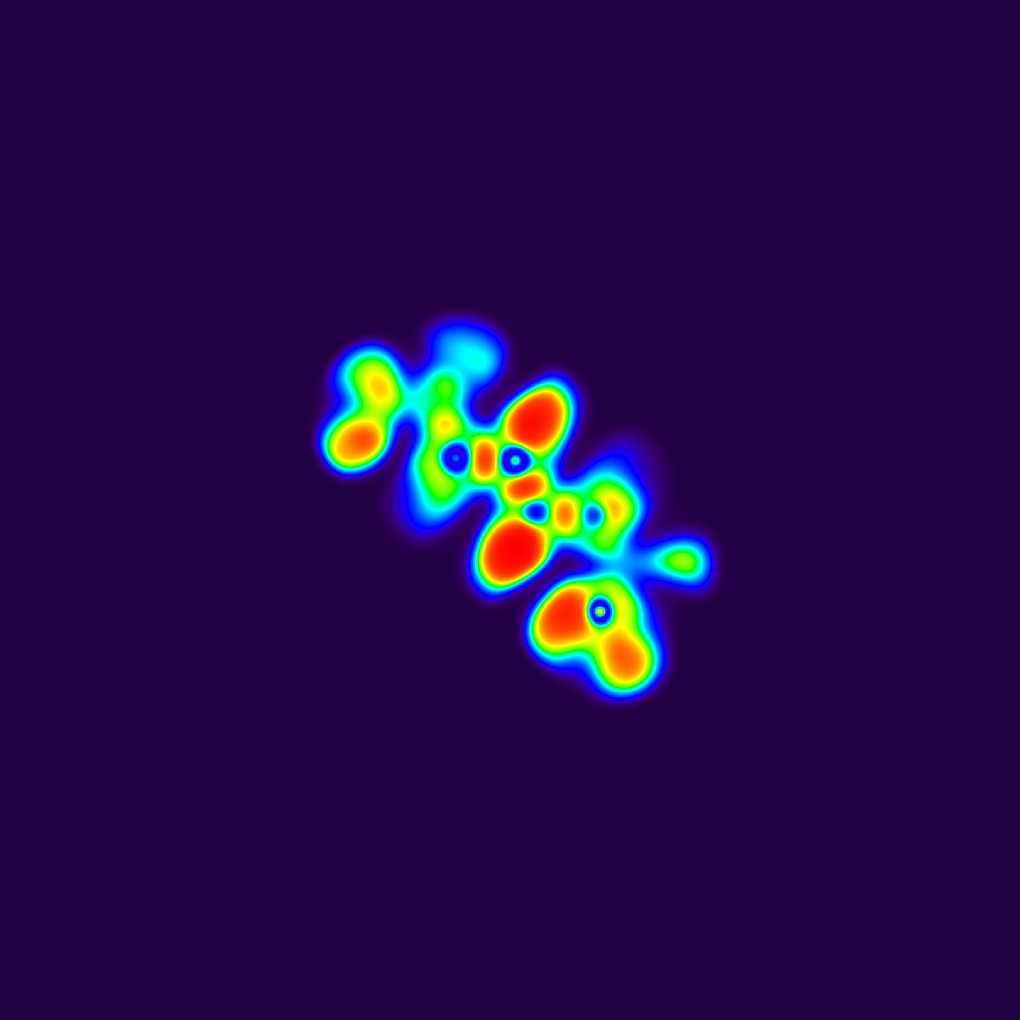
2025.07.17 - [💻 본업(컴공생) 이야기] - 에너지맵, ELF와 ESP 에너지맵, ELF와 ESP에너지맵(Energy Map)은 말 그대로 에너지 흐름과 상태를 시각적으로 보여주는 지도이다. 다양한 에너지 맵 중!원자와 분자, 그리고 물질 속에서 전자가 어떻게 분포하고 상호작용하는지를 이해하real-st-ory.tistory.com 모델에 ELF와 ESP에너지 맵의 특징을 더효과적으로 학습시키기 위해서는 특정 특징을 살리고 죽(?)여야할지 정하는 것이 중요할 수 있다.따라서 각 이미지 별 어떤 특징들이 있는지 먼저 분석해보려고 한다. ELF (전자 국소화 함수) 색상 스케일이 일반적으로 빨간색이 높은 국소화(전자가 강하게 집중된 곳), 파란색이 낮은 국소화(전자가 분산된 곳)를 나타낸다.시..

에너지맵, ELF와 ESP

에너지맵(Energy Map)은 말 그대로 에너지 흐름과 상태를 시각적으로 보여주는 지도이다. 다양한 에너지 맵 중!원자와 분자, 그리고 물질 속에서 전자가 어떻게 분포하고 상호작용하는지를 이해하는 데 필수적인 두 가지 강력한 도구,바로 정전기 전위 지도(Electrostatic Potential, ESP)와 ,전자 국지화 함수(Electron Localization Function, ELF)에 대해 공부해보았다. 우리가 사는 세상의 모든 것은 원자로 이루어져 있고, 이 원자 속에는 전자라는 아주 작고 중요한 알갱이들이 들어있다.이 전자들은 원자와 원자를 이어 붙여 분자를 만들고, 이 분자들이 모여 다양한 물질을 만든다.그런데 사실, 전자는 너무 작아서 눈에 보이지 않는다. 그러나, 연구자들이나 과학자..

[Dataset 탐색하기] Quantum Mechanics 데이터셋 (QM7, QM8,QM9)

https://moleculenet.org/datasets-1Quantum Mechanics 데이터셋이란? Datasets moleculenet.org Quantum Mechanics 데이터셋은 슈뢰딩거 방정식을 (DFT 같은 기법으로 근사적으로) 해결하여 계산되는 특성들을 나타내는 데이터셋 Generalizable, Fast, and Accurate DeepQSPR with fastprop으로, 분자의 양자역학적 성질을 머신러닝으로 예측하기 위한 벤치마크 데이터셋입니다.주요 QM 데이터셋들1. QM7 데이터셋구성: 7,165개 분자, 최대 23개 원자 (7개 헤비원자 C, N, O, S 포함) Spectroscopic (FT-IR, FT-Raman) investigation, topology (ESP..

카테고리 없음 2025.07.16

분자 구조 시각화 방법론 (ELF, ESP, HOMO-LUMO)

ELF, ESP, HOMO-LUMO 이 세 가지 방법론은 모두 분자의 전자 밀도 또는 전자 구조와 관련된 정보를 바탕으로 분자의 특정 물리화학적 특성이나 반응성을 공간적으로 시각화하는 데 사용됩니다. 주로 양자화학 계산을 통해 얻어지는 데이터에 기반합니다.1. ELF (Electron Localization Function)무엇일까?ELF는 전자들이 특정 공간에 얼마나 강하게 국소화(localized)되어 있는지를 나타내는 함수입니다. 간단히 말해, 전자가 원자 주위나 화학 결합 내에 얼마나 밀집되어 있는지를 보여주는 지표입니다.원리 및 시각화전자 밀도가 높은 곳(예: 원자핵 주변, 공유 결합 내)에서는 ELF 값이 높아집니다. 이는 전자들이 해당 영역에 강하게 묶여 있음을 의미합니다.ELF 값은 0과 ..

[논문 리뷰] ChemBERTa-2

https://arxiv.org/abs/2209.01712 ChemBERTa-2: Towards Chemical Foundation ModelsLarge pretrained models such as GPT-3 have had tremendous impact on modern natural language processing by leveraging self-supervised learning to learn salient representations that can be used to readily finetune on a wide variety of downstream tasks. We inarxiv.org 논문 개요이 논문은 자연어 처리(NLP) 분야에서 성공을 거둔 대규모 사전학습 언어 모델(GP..

사전학습(Pre-training)과 준지도 사전학습(semi-supervised pre-training), 그리고 BERT

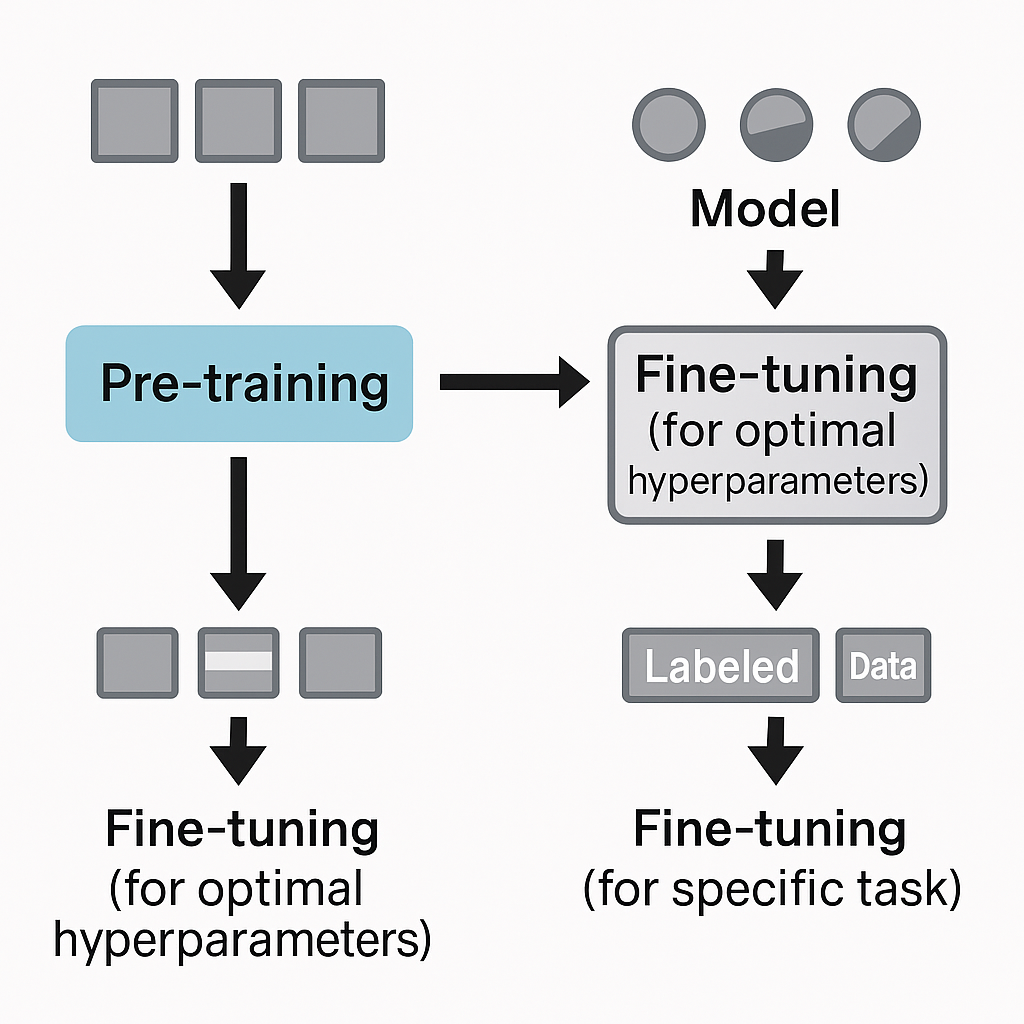
pre-training의 필요성현대의 딥러닝 모델은 대규모 파라미터와 복잡한 구조를 가지고 있다.따라서, 이를 효과적으로 학습시키기 위해서는 방대한 양의 데이터와 안정된 학습 전략이 필요하다. 그러나 현실에서는 충분한 라벨된 데이터를 확보하기 어렵고, 특히 약물, 단백질, 의료 등의 분야에서는 라벨링 비용도 높다.쉽게 말하면, 지도학습(supervised learning)은 정답(label)이 붙은 데이터가 있어야 하지만, 현실에서 라벨 데이터를 수집하는 일은 매우 어렵고 비용이 많이 든다.반면, 라벨 없는 데이터(예를 들어, 분자 구조, 단백질 서열, 자연어 문장)는 무한에 가깝게 존재한다. 프리트레이닝은 이 데이터들을 이용하여 모델이 일반적인 ‘감’을 익히게 만든다고 생각하면 쉽다. 이러한 한계를 극..

728x90
반응형
LIST